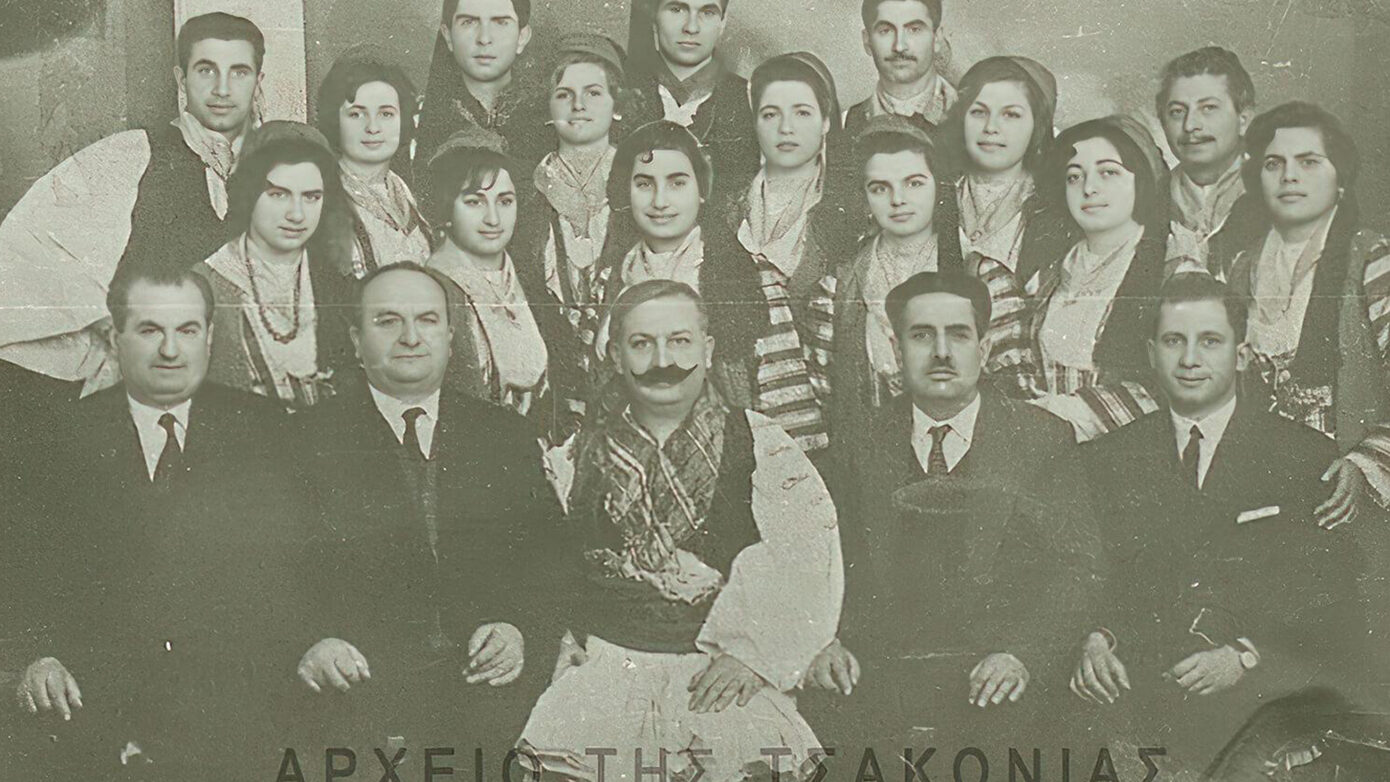
Πέντε ελληνικά έργα επιδιώκουν να ενισχύσουν την παρουσία των Τσακώνικων, των Ποντιακών και της Ρομανί στην Τεχνητή Νοημοσύνη, καθώς το διαθέσιμο ψηφιακό υλικό για αυτές τις γλώσσες και διαλέκτους παραμένει περιορισμένο. Στο πλαίσιο της πρωτοβουλίας LINGUA της Microsoft, καταγράφουν προφορικές μαρτυρίες, ψηφιοποιούν αρχεία και παράγουν γλωσσικά δεδομένα.
Μεταξύ των χωρών που συμμετείχαν στον ευρωπαϊκό κύκλο, η Ελλάδα είχε τα περισσότερα έργα που διακρίθηκαν. Στόχος είναι να εκπροσωπούνται περισσότερες φωνές στις τεχνολογίες που επηρεάζουν την καθημερινή μας ζωή.
Περίπου 7.000 γλώσσες χρησιμοποιούνται σήμερα παγκοσμίως, όμως οι περισσότερες έχουν μικρή παρουσία στο διαδίκτυο. Αυτό, στην εποχή της Τεχνητής Νοημοσύνης, δημιουργεί μια νέα ανισότητα: γλώσσες που δεν εκπροσωπούνται ψηφιακά λείπουν σε μεγάλο βαθμό και από τα δεδομένα με τα οποία εκπαιδεύονται και αναπτύσσονται οι νέες τεχνολογίες.
Το ζήτημα αφορά ιδιαίτερα την Ελλάδα, όπου αρκετές γλώσσες και διάλεκτοι διαθέτουν ακόμη μικρότερο ψηφιακό αποτύπωμα. Η Ρομανί, η Τσακωνική, η Καππαδοκική, η Ποντιακή, τα Αρβανίτικα και άλλες γλωσσικές ποικιλίες ανήκουν σε μια πολιτιστική και γλωσσική κληρονομιά που χρειάζεται να εκπροσωπηθεί και στον ψηφιακό χώρο.
Την πρόκληση αυτή επιχειρεί να αντιμετωπίσει η πρωτοβουλία LINGUA της Microsoft. Στηρίζει ερευνητές και οργανισμούς που καταγράφουν και τεκμηριώνουν γλώσσες και διαλέκτους με λίγα διαθέσιμα δεδομένα, επιδιώκοντας να ενισχύσουν την ψηφιακή παρουσία τους.
Ποια είναι τα πέντε ελληνικά έργα που διακρίθηκαν
Τα πέντε έργα που επιλέχθηκαν καταδεικνύουν τον πλούτο της γλωσσικής παράδοσης στην Ελλάδα, αλλά και τη δυναμική της ελληνικής ερευνητικής και επιστημονικής κοινότητας. Παράλληλα, δείχνουν πώς η τεχνολογία μπορεί να αξιοποιηθεί για τη διατήρηση αυτής της παράδοσης.
Χρηματοδότηση 50.000 ευρώ έλαβε η ΑΡΣΙΣ – Κοινωνική Οργάνωση Υποστήριξης Νέων, προκειμένου να ψηφιοποιήσει γλωσσικό υλικό της Ρομανί. Άλλες τέσσερις πρωτοβουλίες θα λάβουν πιστώσεις Azure και θα έχουν πρόσβαση στην τεχνογνωσία του AI for Good Lab της Microsoft:
- Το CoDAG του Πανεπιστημίου Κρήτης.
- Το LALIES του Ινστιτούτου Επεξεργασίας του Λόγου του Ερευνητικού Κέντρου «Αθηνά».
- Το T.S.A.K.O.N.I.A. του Αρχείου της Τσακωνιάς.
- Το Istorima.
Η σημασία της ψηφιακής παρουσίας για κάθε γλώσσα
Τα έργα έχουν ως κοινό σημείο ένα βασικό ερώτημα: με ποιον τρόπο μπορεί να διασφαλιστεί η γλωσσική πολυμορφία, όσο όλο και περισσότερη γνώση και ανθρώπινη επικοινωνία μεταφέρεται στο ψηφιακό περιβάλλον;
Κρίσιμο πρώτο βήμα είναι η συγκέντρωση δεδομένων. Με την καταγραφή προφορικού λόγου, την ψηφιοποίηση αρχείων, τη συγκρότηση γλωσσικών σωμάτων και την ανάπτυξη νέων ψηφιακών εργαλείων, γλώσσες και διάλεκτοι με περιορισμένη παρουσία μπορούν να γίνουν πιο ορατές και χρήσιμες στην εποχή της Τεχνητής Νοημοσύνης.
Ο Ουασίμ Χαμιντούς, επικεφαλής ερευνητής στο εργαστήριο AI for Good της Microsoft, εξήγησε ότι η έλλειψη γλωσσικών δεδομένων μειώνει την αποτελεσματικότητα των αντίστοιχων εργαλείων. Ενδέχεται, επίσης, να δυσκολέψει την ισότιμη πρόσβαση των ομιλητών στην τεχνολογία, την εκπαίδευση και τις νέες ευκαιρίες.
«Η γλώσσα μεταφέρει την ιστορία, τις αξίες και την ταυτότητα των ανθρώπων. Όταν μια γλώσσα δεν έχει ψηφιακή παρουσία, κινδυνεύει να χαθεί μαζί με ένα σημαντικό κομμάτι του πολιτισμού που εκπροσωπεί», σημειώνει η Γιάννα Ανδρονοπούλου, CEO της Microsoft Ελλάδας, Κύπρου, Μάλτας και Αδριατικής. «Και αφού μάθαμε την τεχνητή νοημοσύνη να μιλά, τώρα ήρθε η ώρα να της μάθουμε να ακούει όλες τις φωνές».
Η υλοποίηση του LINGUA εντάσσεται στα ευρύτερα European Digital Commitments της Microsoft. Η πρωτοβουλία αποσκοπεί στην ενδυνάμωση της ψηφιακής παρουσίας γλωσσών για τις οποίες υπάρχει περιορισμένο περιεχόμενο, καθώς και στη διαφύλαξη της γλωσσικής και πολιτιστικής πολυμορφίας στην Ευρώπη.